Data stack 0 đồng với dlt, DuckDB, dbt và anfra
TL;DR. Bạn có thể xây dựng data stack đi từ một public API đến dashboard với chi phí $0 mỗi tháng, chỉ bằng năm công cụ open-source: dlt (ingestion), DuckDB (storage), dbt Core (transformation), GitHub Actions (orchestration) và anfra (semantic layer và BI). Trong bài này, mình sẽ xây một stack như vậy, dùng dữ liệu hoạt động trên GitHub của chính các công cụ này.
Code: lelouvincx/zero-dollar-data-stack.
Dashboard: zero-dollar-data-stack.pages.holistics.dev.
1. Giới thiệu
Nếu bạn là data engineer hoặc analytics engineer và đang muốn:
- một stack miễn phí cho CV project, team nhỏ hoặc startup
- xem “BI as code” trông như thế nào trong thực tế
Vậy thì bài này dành cho bạn.
Đọc xong bài này, bạn sẽ có thể:
- xây được data pipeline từ GitHub API vào DuckDB với dlt và dbt
- lên lịch chạy hằng ngày bằng GitHub Actions
- định nghĩa metric trong semantic layer, rồi để AI agent xây dashboard dựa trên các metric đó
Bối cảnh
Ba năm trước, hồi còn là sinh viên, mình đã xây dựng modern data stack tại project Goodreads ELT pipeline. Project này lấy cảm hứng từ kiến trúc microservice và chạy 11 docker container trên laptop của mình: MySQL, Postgres, MinIO, Spark, Dagster, Metabase. Nó chạy được. Nhưng nó cũng ngốn tận 4GB RAM, 6 CPU và cả một buổi chiều chỉ để khởi động trên chiếc laptop ASUS cũ của mình.
Ba năm sau, data stack open-source đã nhẹ hơn nhiều. Bây giờ DuckDB có thể thay cho Postgres và MinIO. dbt chạy trên DuckDB. GitHub Actions thay cho Dagster. Giờ layer nào cũng có một lựa chọn mặc định miễn phí mà mình chỉ việc chạy.
Trừ một layer: BI.
Với BI, lựa chọn của bạn đại khái vẫn chỉ có:
- trả tiền theo user cho một công cụ BI dạng cloud
- tự host một công cụ kéo thả (Metabase), rồi định nghĩa lại metric trong từng chart
- nhờ AI xây dashboard trên raw data và cầu mong lần nào nó cũng tính revenue theo cùng một cách
Nên lần này mình thử lấp khoảng trống đó bằng anfra, một framework open-source dùng để xây BI app. anfra khá hào phóng với phiên bản miễn phí, đủ cho nhu cầu của project này.
2. Mục tiêu
Dữ liệu của project là hoạt động trên GitHub của chính các công cụ trong stack, cộng thêm vài đối thủ cùng loại. Nói cách khác, stack này tự phân tích chính nó 😄
Project theo dõi 9 repo:
| Layer | Repo |
|---|---|
| Ingestion | dlt-hub/dlt |
| Storage | duckdb/duckdb |
| Transformation | dbt-labs/dbt, SQLMesh/sqlmesh |
| Semantic layer và BI | holistics/anfra, cube-js/cube, evidence-dev/evidence, metabase/metabase, apache/superset |
Muốn thêm repo khác? Bạn có thể gửi PR.
Câu hỏi đặt ra là: trong các công cụ data open-source này, công cụ nào đang được maintain tốt nhất?
Số star cho biết một công cụ nổi tiếng đến đâu, nhưng không cho biết nó có được maintain tốt hay không. Vì vậy, mình đo bốn chỉ số mà bạn nên xem trước khi chọn công cụ cho một project thật:
- Tốc độ phản hồi: khi có người mở issue mới, bao lâu sau maintainer trả lời?
- Tần suất release: project có ra phiên bản mới đều đặn không?
- Đóng góp từ community: bao nhiêu pull request đến từ người ngoài core team?
- Xu hướng hoạt động: số issue và pull request mới đang tăng hay giảm?
3. Thiết kế
3.1 Stack
| Layer | Tool | Chi phí | Giới hạn miễn phí |
|---|---|---|---|
| Ingestion | dlt | $0 | open source |
| Storage | DuckDB (local), MotherDuck (chia sẻ) | $0 | DuckDB: open source. Gói MotherDuck Lite: 10 GB storage, 10 giờ compute mỗi tháng, tối đa 3 user, không cần thẻ tín dụng |
| Transformation | dbt Core + dbt-duckdb | $0 | open source |
| Orchestration | GitHub Actions | $0 | public repo được dùng runner chuẩn của GitHub miễn phí, không giới hạn số phút (private repo trên GitHub Free có $12 compute mỗi tháng, khoảng 2,000 phút Linux) |
| Semantic layer và BI | anfra | $0 | CLI open source |
| Chia sẻ | anfra Cloud | $0 | miễn phí trong giai đoạn beta |
| Builder | Claude Code, Codex hoặc AI agent khác | $20/tháng (gói Claude) |
Nếu nằm trong giới hạn miễn phí, cả stack sẽ hoàn toàn miễn phí. Khoản duy nhất mình phải trả là AI agent dùng để viết code.
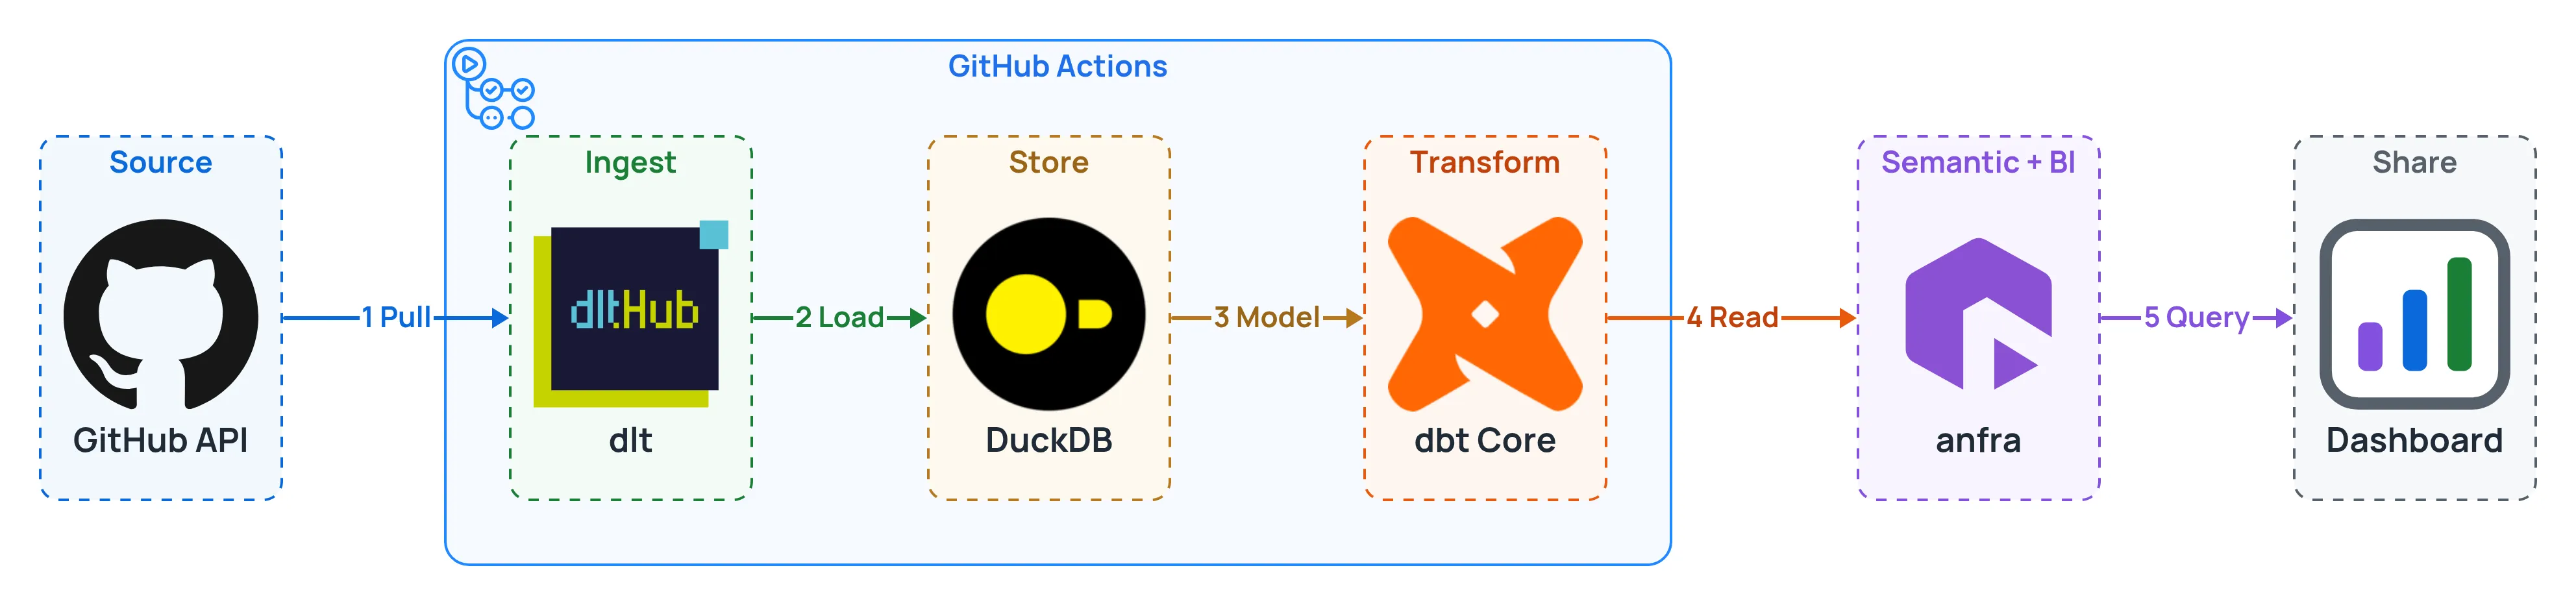
Vào 01:00 UTC (8 giờ sáng giờ Việt Nam) mỗi ngày, GitHub Actions chạy bước 1 đến bước 3:
- Pull:
dltlấy các issue, pull request và release mới hoặc vừa cập nhật từ GitHub API. - Load:
dltghi dữ liệu vào DuckDB. - Model:
dbtlàm sạch dữ liệu ở các staging model, rồi build dbt model. - Read marts:
anfrađọc các dbt model qua AML model và dataset. Mỗi metric chỉ được định nghĩa một lần ở đây. - Query: dashboard gọi metric từ anfra.
3.2 Cấu trúc thư mục
zero-dollar-data-stack/
├── ingest/                    # dlt pipeline: repos, issues, pull requests and releases from the GitHub API
├── transform/                 # dbt project: staging and marts on DuckDB
├── anfra/                     # the anfra project
│   ├── .anfra/
│   │   ├── data_sources.yml     # the warehouse connection
│   │   └── context_sources.yml  # points anfra at the dbt project
│   ├── models/                # semantic layer, in AML
│   ├── datasets/              # semantic layer, in AML
│   └── apps/                  # the dashboard, one HTML file
├── .github/
│   └── workflows/
│       ├── refresh.yml        # daily ingest and transform
│       └── validate.yml       # runs `anfra validate` on every pull request
├── Makefile                   # shortcuts
└── AGENTS.md                  # agent's instruction for development and maintenance
3.3 Data model
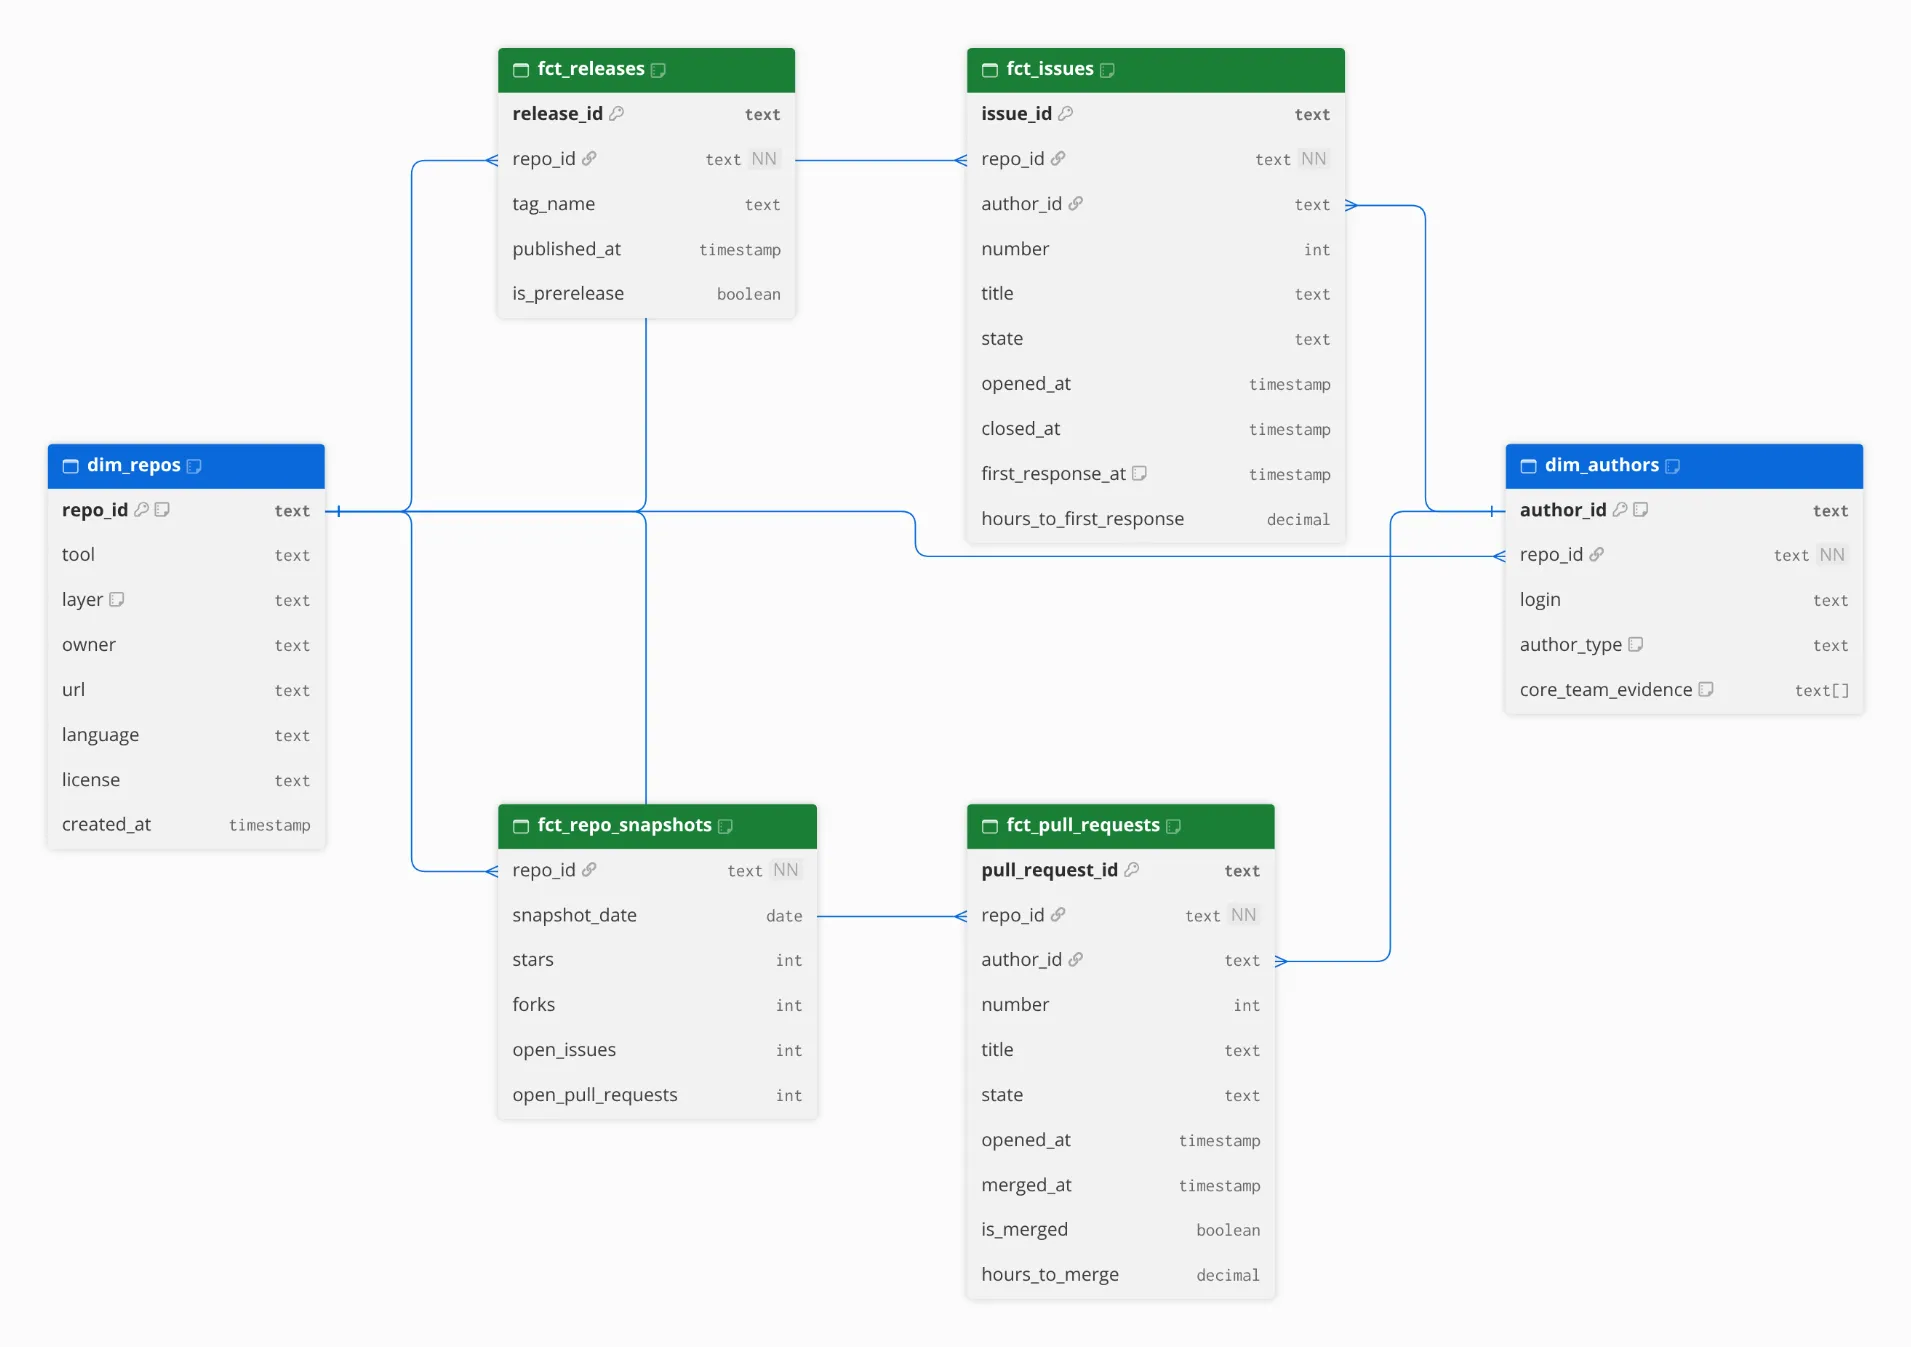
dim_repos: mỗi repo một dòng, kèm tên tool, layer, owner, ngôn ngữ và licensedim_authors: mỗi dòng là một người trong một repo, kèm loại author: core team, community hoặc bot. Loại author được xác định theo từng repo, vì một người có thể thuộc core team ở repo này nhưng chỉ là community ở repo khác.fct_issues: mỗi issue một dòng, kèm thời điểm mở và thời điểm maintainer phản hồi lần đầufct_pull_requests: mỗi pull request một dòng, kèm thời điểm mergefct_releases: mỗi release một dòng, kèm tag và thời điểm publishfct_repo_snapshots: mỗi repo mỗi ngày một dòng, kèm số star, số fork, số issue và pull request đang mở. Số star đổi hằng ngày, nên nó nằm ở bảng này thay vìdim_repos.
4. Cài đặt
4.1 Chuẩn bị
- Một GitHub token có quyền đọc public repo, để tránh API rate limit
- Một AI agent: Claude Code, Codex, Amp hoặc công cụ tương tự
4.2 Clone và cài đặt
git clone https://github.com/lelouvincx/zero-dollar-data-stack.git
cd zero-dollar-data-stack
make install   # uv sync: dlt, dbt-duckdb and their dependencies
4.3 Cài anfra
anfra gồm hai phần: CLI và bộ skill hướng dẫn AI agent dùng CLI đó:
curl -fsSL https://anfra.ai/install.sh | bash
anfra agent setup   # installs the skills for Claude Code and Codex
Với agent khác như Amp, cài skill bằng lệnh npx skills add holistics/anfra-skills -a <agent-id> -g -y.
5. Chi tiết từng bước
5.1 Ingest với dlt
Mình chọn GraphQL API của GitHub thay vì REST. Chỉ với một query, mình lấy được issue, author, vai trò của author và 10 comment đầu tiên. dlt lo phần còn lại:
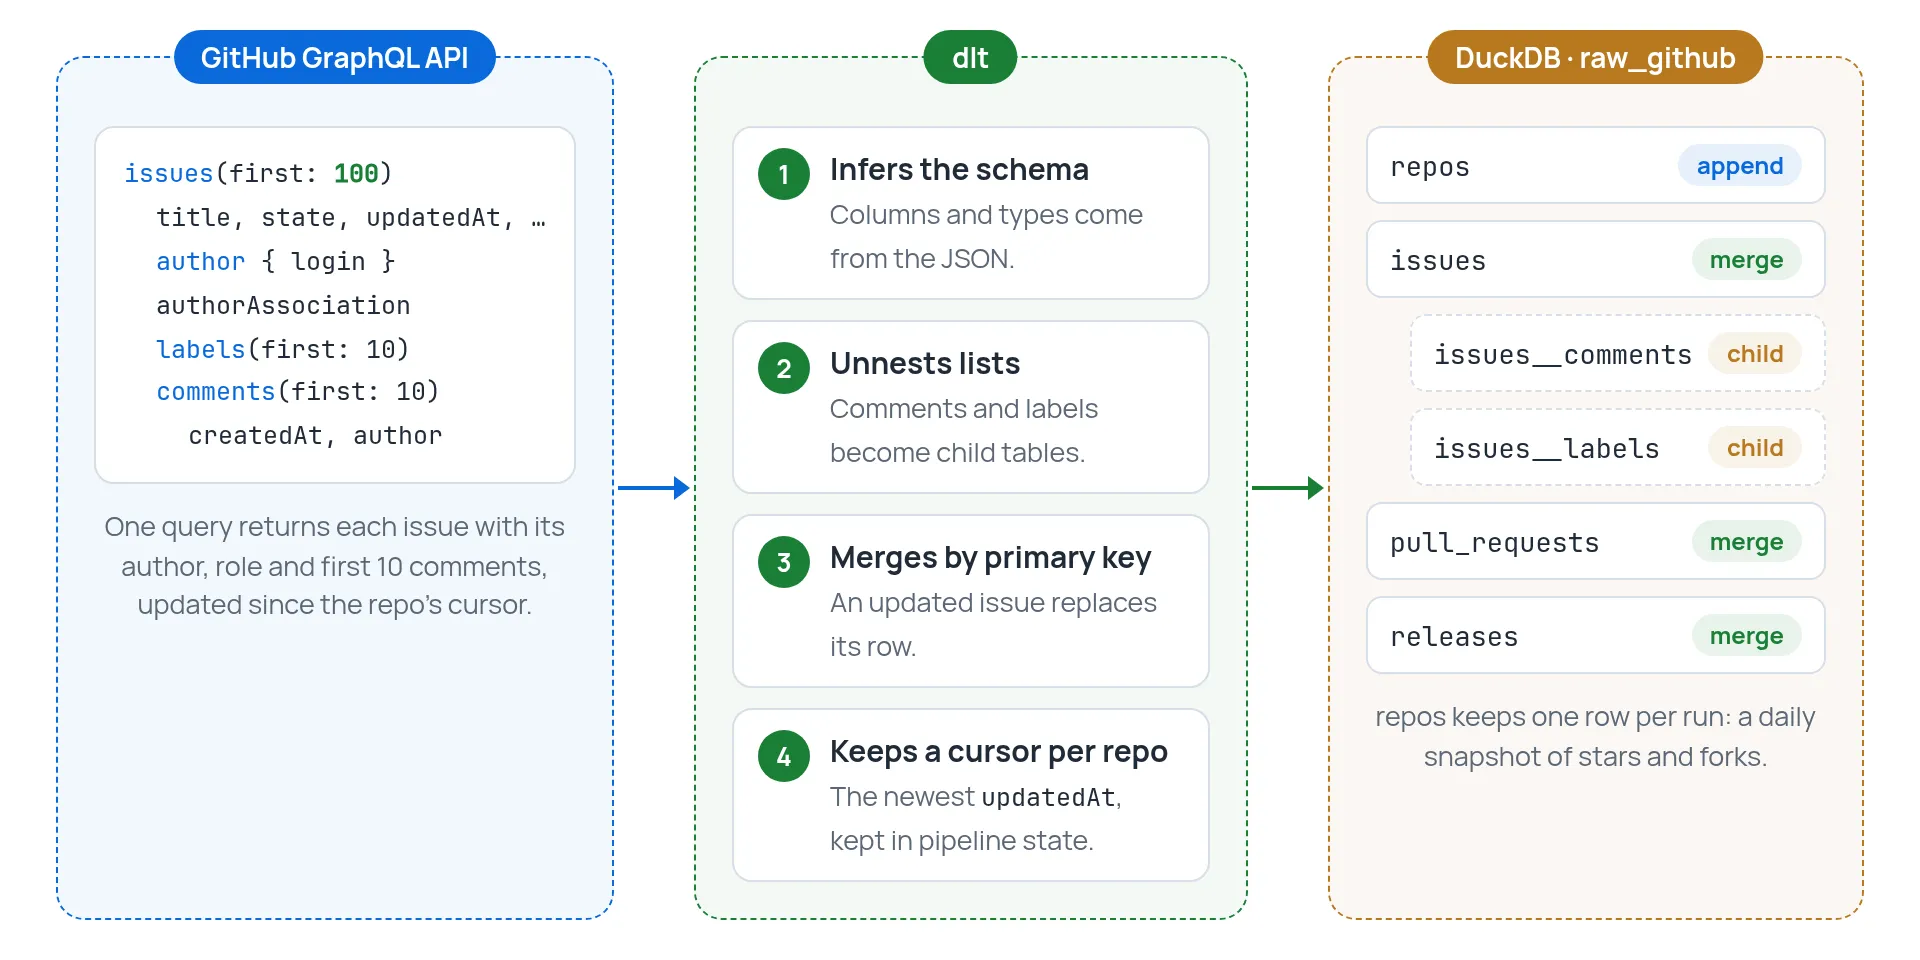
Cả pipeline nằm trong một file, ingest/github_pipeline.py. Muốn theo dõi thêm tool, bạn chỉ cần thêm repo vào REPOS rồi gửi PR.
Lần load đầu tiên lấy dữ liệu 365 ngày của 9 repo, gồm khoảng 15,000 issue, 34,000 comment, 47,500 pull request và 586 release. Quá trình này mất khoảng 26 phút. Sau đó, incremental load hằng ngày sẽ chỉ mất khoảng nửa phút trên GitHub Actions.
5.2 Transform với dbt
Nếu bạn mới làm quen, hãy bắt đầu với dbt tutorial của Start Data Engineering.
Project có ba layer: staging model làm sạch từng bảng raw, sau đó mart join chúng thành các bảng fact và dimension cho dashboard.
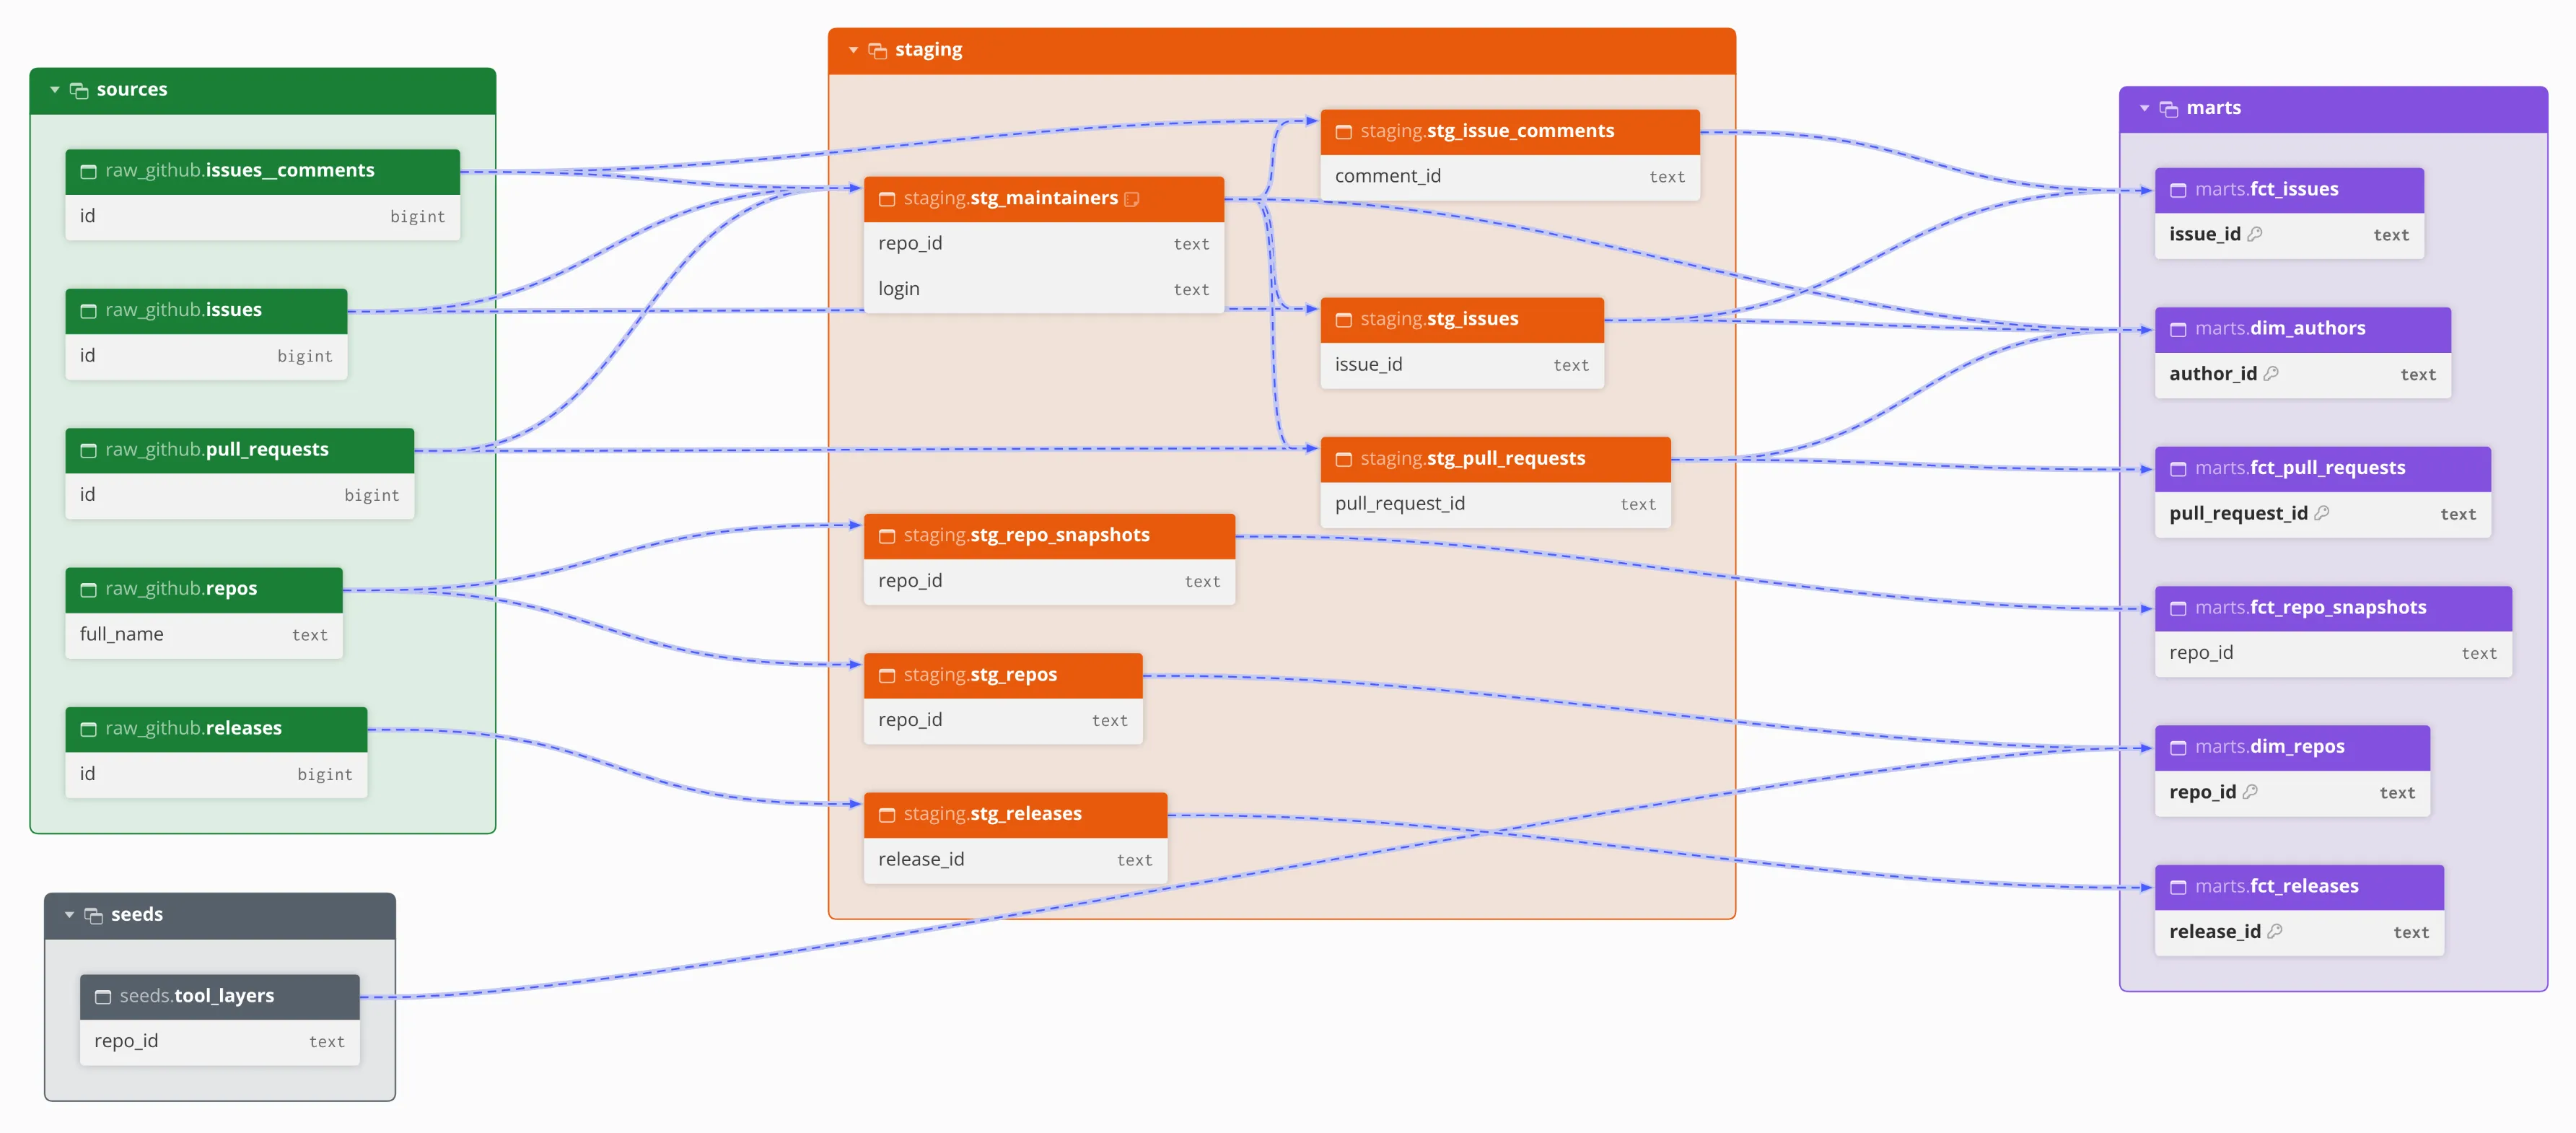
Model quan trọng nhất là stg_maintainers. Model này xác định ai thuộc core team, nên mọi chỉ số về thời gian maintainer phản hồi đều phụ thuộc vào nó.
Các model nằm trong transform/models.
5.3 Lên lịch với GitHub Actions
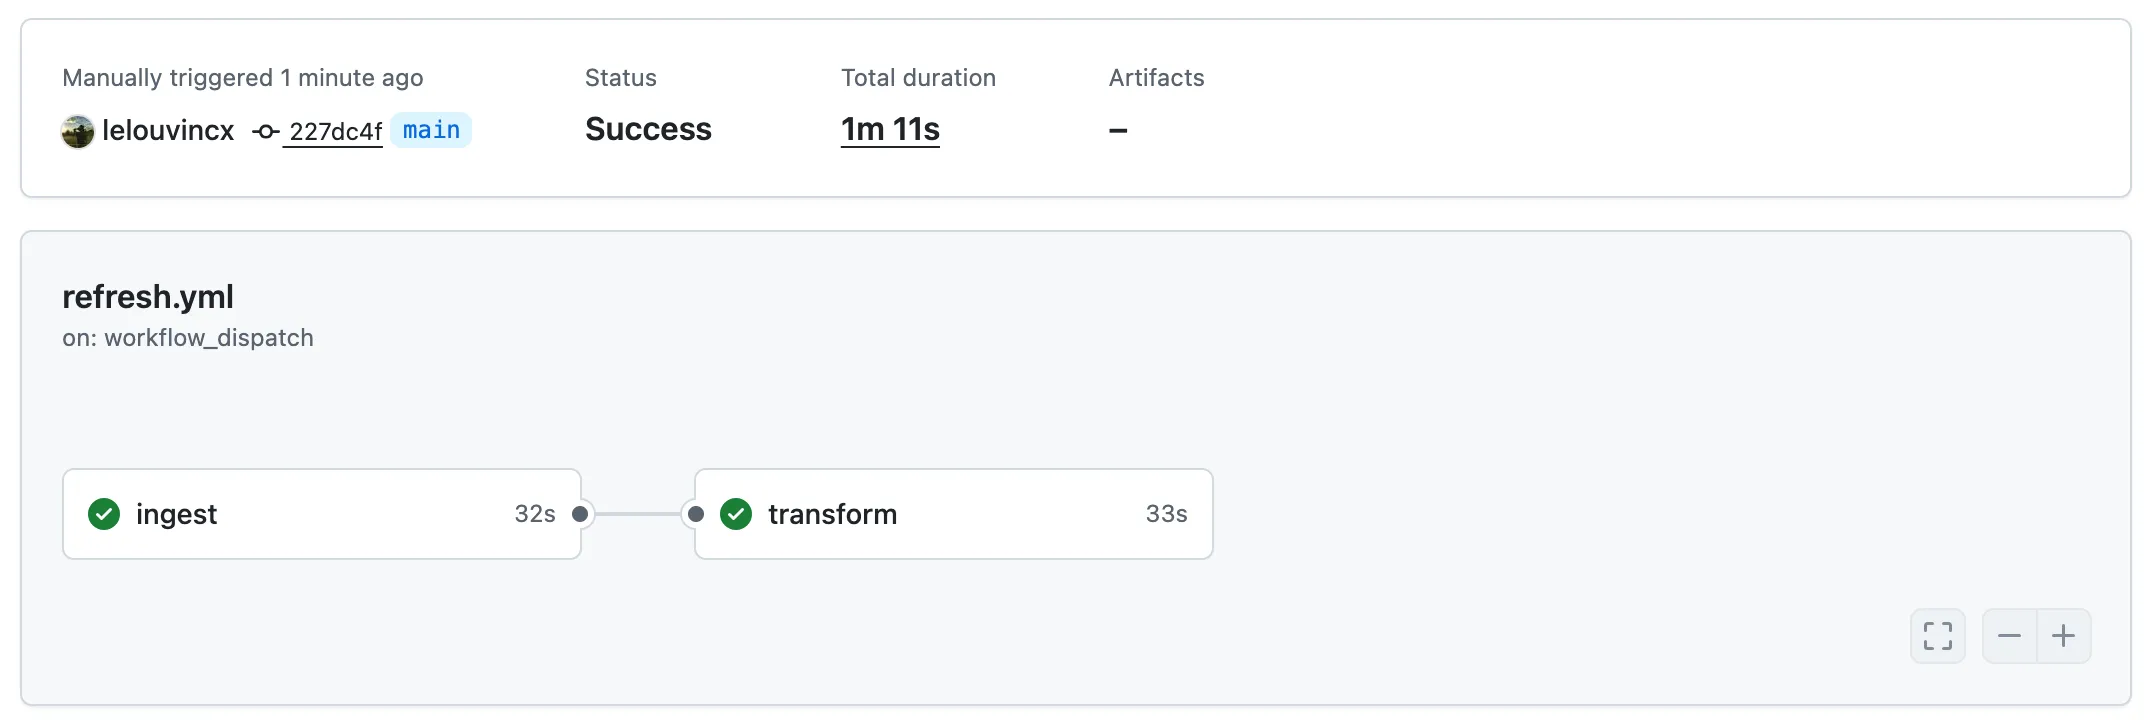
Một workflow chạy lúc 01:00 UTC mỗi ngày. Bạn cũng có thể chạy thủ công từ tab Actions. Workflow gồm hai job: ingest chạy make ingest, rồi transform chạy make transform nếu ingest thành công. Khi dbt lỗi, bạn chỉ cần chạy lại job transform, không phải load lại dữ liệu. Mỗi job chỉ được cấp đúng token mình cần từ repository secrets.
Mỗi lần chạy mất khoảng một phút: ingest 32 giây, transform 33 giây.
5.4 Định nghĩa metric với anfra
Đây là phần mà các stack miễn phí trước đây còn thiếu.
dbt tạo ra các bảng, nhưng không định nghĩa “median response time” là gì, hay bot có được tính là contributor không. Khi thiếu định nghĩa chung, mỗi chart và mỗi prompt AI sẽ tự tính theo một kiểu. anfra thêm một semantic layer bên trên các dbt mart. Model, metric và join đều viết bằng code và được review qua pull request, giống dbt project.
Đầu tiên, khởi tạo anfra project:
cd anfra
anfra init .   # adds .anfra/, models/, datasets/ and apps/; changes no existing file
Kết nối warehouse. Ở local, warehouse chính là file DuckDB:
# anfra/.anfra/data_sources.yml  (git-ignored when it holds credentials)
data_sources:
  github:
    type: duckdb
    connection:
      path: ../data/github.duckdb
Tiếp theo, trỏ anfra tới dbt project để agent đọc được mô tả model và column bạn đã viết trong dbt:
# anfra/.anfra/context_sources.yml
sources:
  - name: dbt_github
    type: dbt
    local: { path: ../transform }
dbt compile --project-dir ../transform # anfra reads target/manifest.json
anfra ingestĐến phần metric. Mỗi metric được định nghĩa một lần, kèm mô tả:
// anfra/datasets/github_health.dataset.aml (excerpt)
Dataset github_health {
  label: 'GitHub health of data tools'
  data_source_name: 'github'
  models: [dim_repos, dim_authors, fct_issues, fct_pull_requests, fct_releases, fct_repo_snapshots]
  relationships: [
    relationship(fct_issues.repo_id > dim_repos.repo_id, true),
    relationship(fct_pull_requests.repo_id > dim_repos.repo_id, true),
    relationship(fct_releases.repo_id > dim_repos.repo_id, true),
    relationship(fct_repo_snapshots.repo_id > dim_repos.repo_id, true),
    relationship(fct_issues.author_id > dim_authors.author_id, true),
    relationship(fct_pull_requests.author_id > dim_authors.author_id, true),
    relationship(dim_authors.repo_id > dim_repos.repo_id, true)
  ]

  metric median_first_response_hours {
    label: 'Median First Response (hours)'
    type: 'number'
    description: 'Median hours from an issue being opened to the first comment by a maintainer. Only issues opened by people outside the core team count, and only those that got a reply.'
    definition: @aql fct_issues | where(dim_authors.author_type == 'community') | median(fct_issues.hours_to_first_response) ;;
  }
  metric community_pr_share {
    label: 'Community PR Share'
    type: 'number'
    description: 'Share of merged pull requests opened by people outside the core team. Bots are excluded from both sides.'
    definition: @aql (fct_pull_requests | where(dim_authors.author_type == 'community') | count_if(fct_pull_requests.is_merged)) * 1.0 / (fct_pull_requests | where(dim_authors.author_type != 'bot') | count_if(fct_pull_requests.is_merged)) ;;
    format: '#,##0.0%'
  }
  // ...7 more: issue_count, response_rate, pr_count, merged_pr_count,
  // median_hours_to_merge, release_count, total_stars
}
Validate rồi chạy thử một query:
anfra validate
anfra query -d github_health 'explore {
  dimensions { tool: dim_repos.tool }
  measures { median_response_h: median_first_response_hours, community_share: community_pr_share }
  sorts { median_response_h asc }
}'
+----------+-------------------------------+-----------------------+
| Tool | Median First Response (hours) | Community PR Share |
+----------+-------------------------------+-----------------------+
| Metabase | 15.641666666666666 | 0.0023978077186572275 |
| DuckDB | 35.225 | 0.3176158399673403 |
| Superset | 75.05000000000001 | 0.30045816252712804 |
| dlt | 104.81666666666666 | 0.21785714285714286 |
| dbt | 224.28333333333333 | 0.07586206896551724 |
| Cube | 276.125 | 0.02707692307692308 |
| SQLMesh | 1534.9166666666665 | 0.5714285714285714 |
| Evidence | 3174.8 | 0 |
| anfra | <none> | 0 |
+----------+-------------------------------+-----------------------+
Timings:
compiling_query 116 ms
executing_query 44 ms
total 242 msKết quả: “median first response” giờ chỉ có một định nghĩa. Dashboard này, dashboard sau, hay bất kỳ AI agent nào dùng metric này đều nhận cùng một con số.
5.5 Xây dashboard
Khi đã có metric, việc xây dashboard chỉ cần vài prompt. Đây là ba prompt mình dùng:
Build an anfra dashboard on github_health that answers: which open-source
data tools are the healthiest to adopt? Compare tools by response time,
community share and releases, and show the trend over time.
Check https://anfra.ai/interaction-patterns/agents.md and apply the
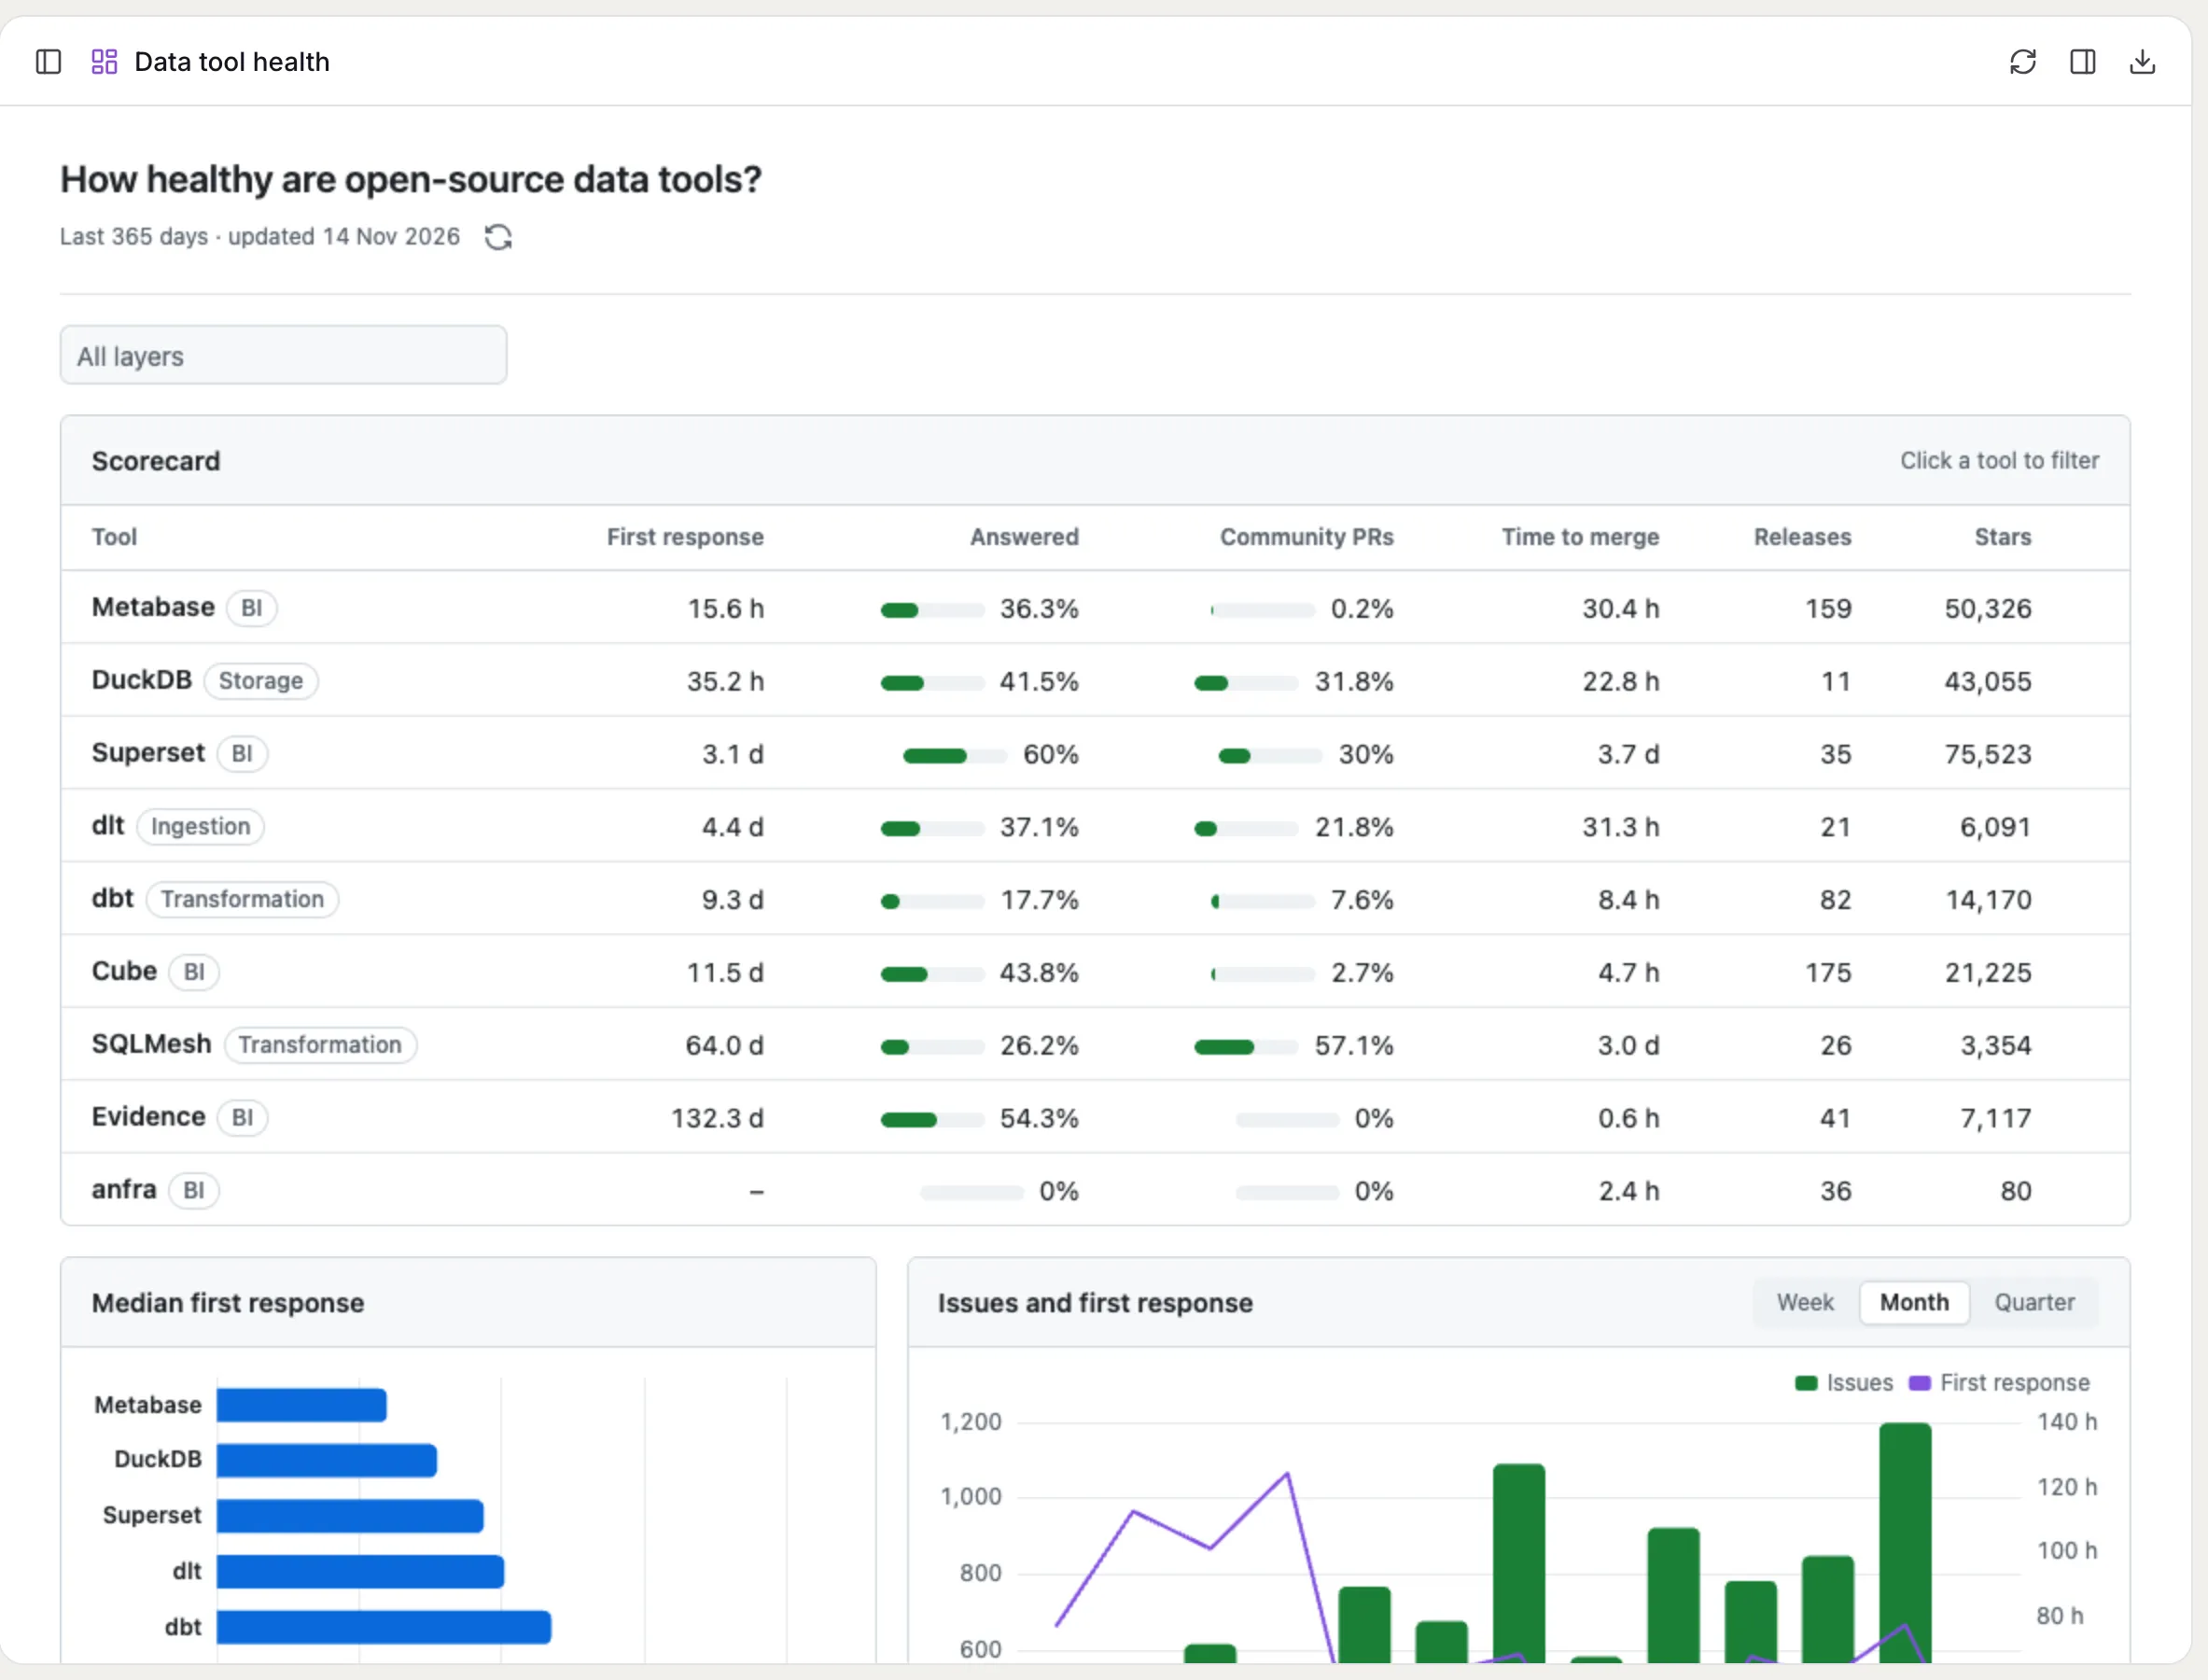
interactions that fit this dashboard.Make it follow GitHub's design system, with less text and some motion.
Add a menu to each table row, with View underlying data on right-click.Agent tự chọn layout, nên dashboard của bạn sẽ gần giống của mình, nhưng không y hệt.
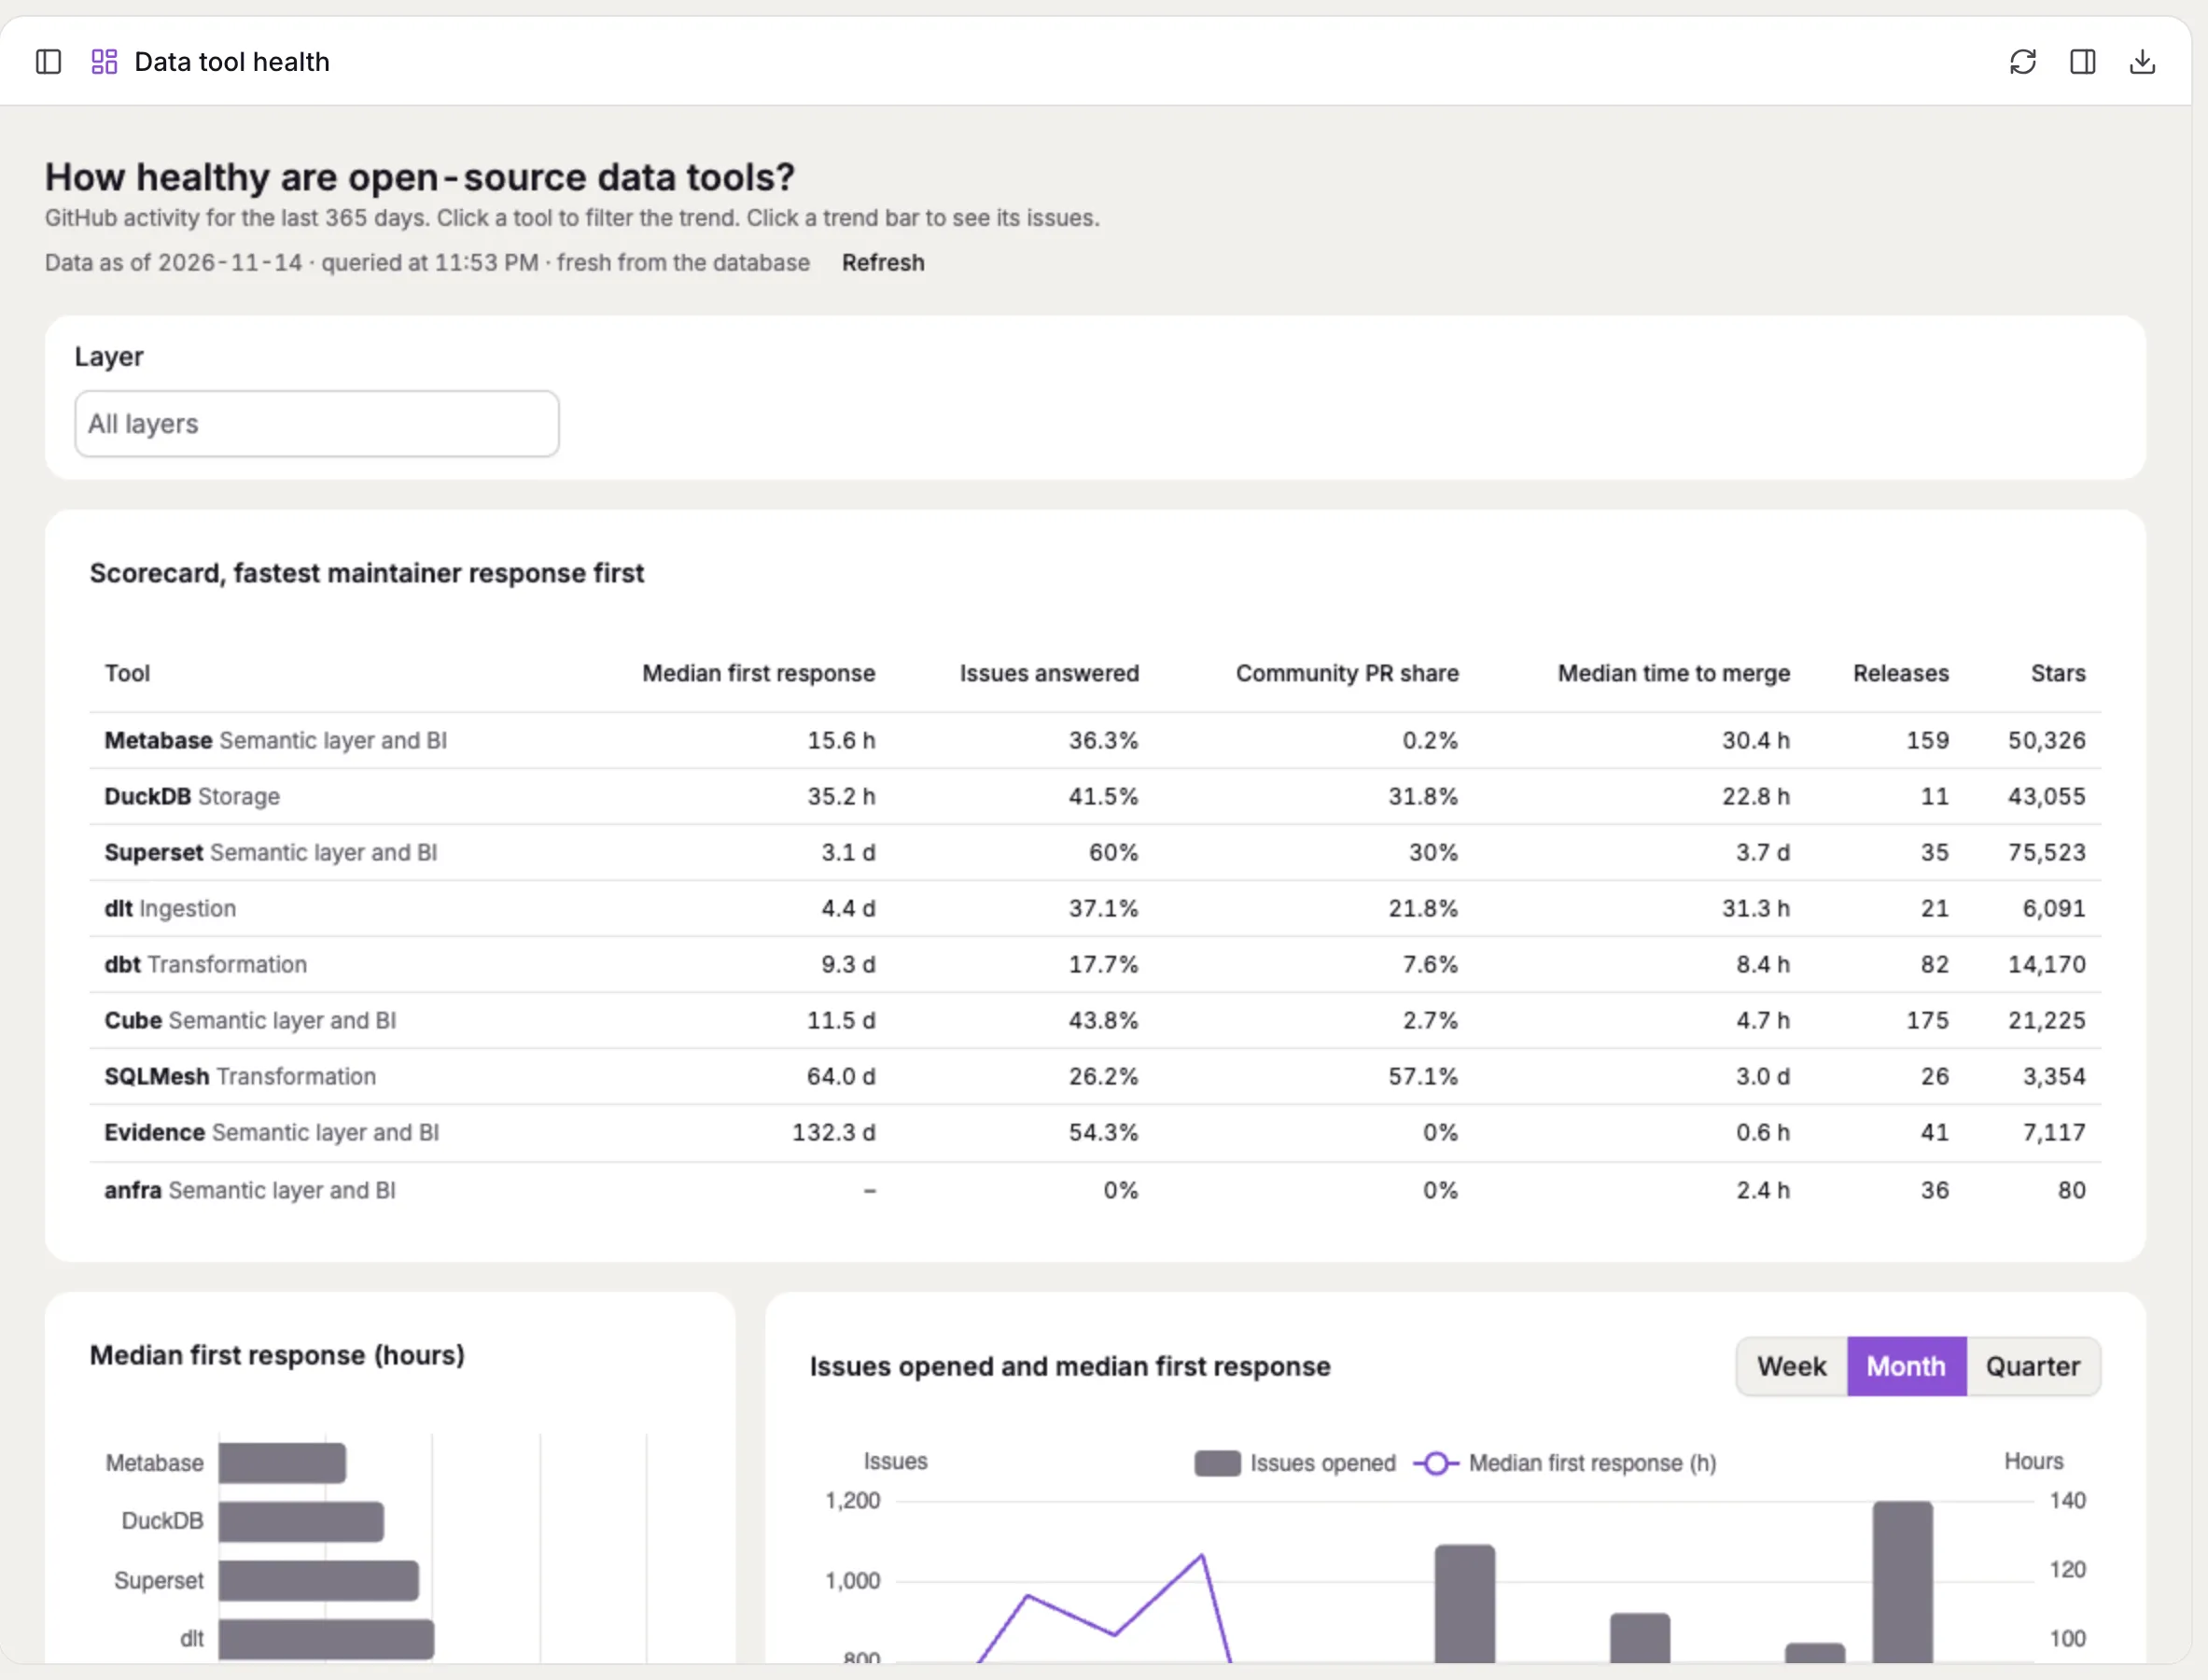
Mỗi prompt mất 10 đến 11 phút. Prompt đầu tạo ra scorecard, bar chart thời gian phản hồi và trend số issue, kèm filter theo layer. Prompt thứ hai thêm tương tác: cột sắp xếp được, dòng “data as of” kèm nút Refresh, filter chip kèm Reset all, và View underlying data trên các cột của trend.
Prompt thứ ba đổi giao diện sang phong cách GitHub, bớt chữ, thêm animation và menu cho từng dòng:
Chạy dashboard ở local:
anfra serveApp chạy tại http://127.0.0.1:7878/ và tự reload mỗi khi agent sửa app hoặc AML.
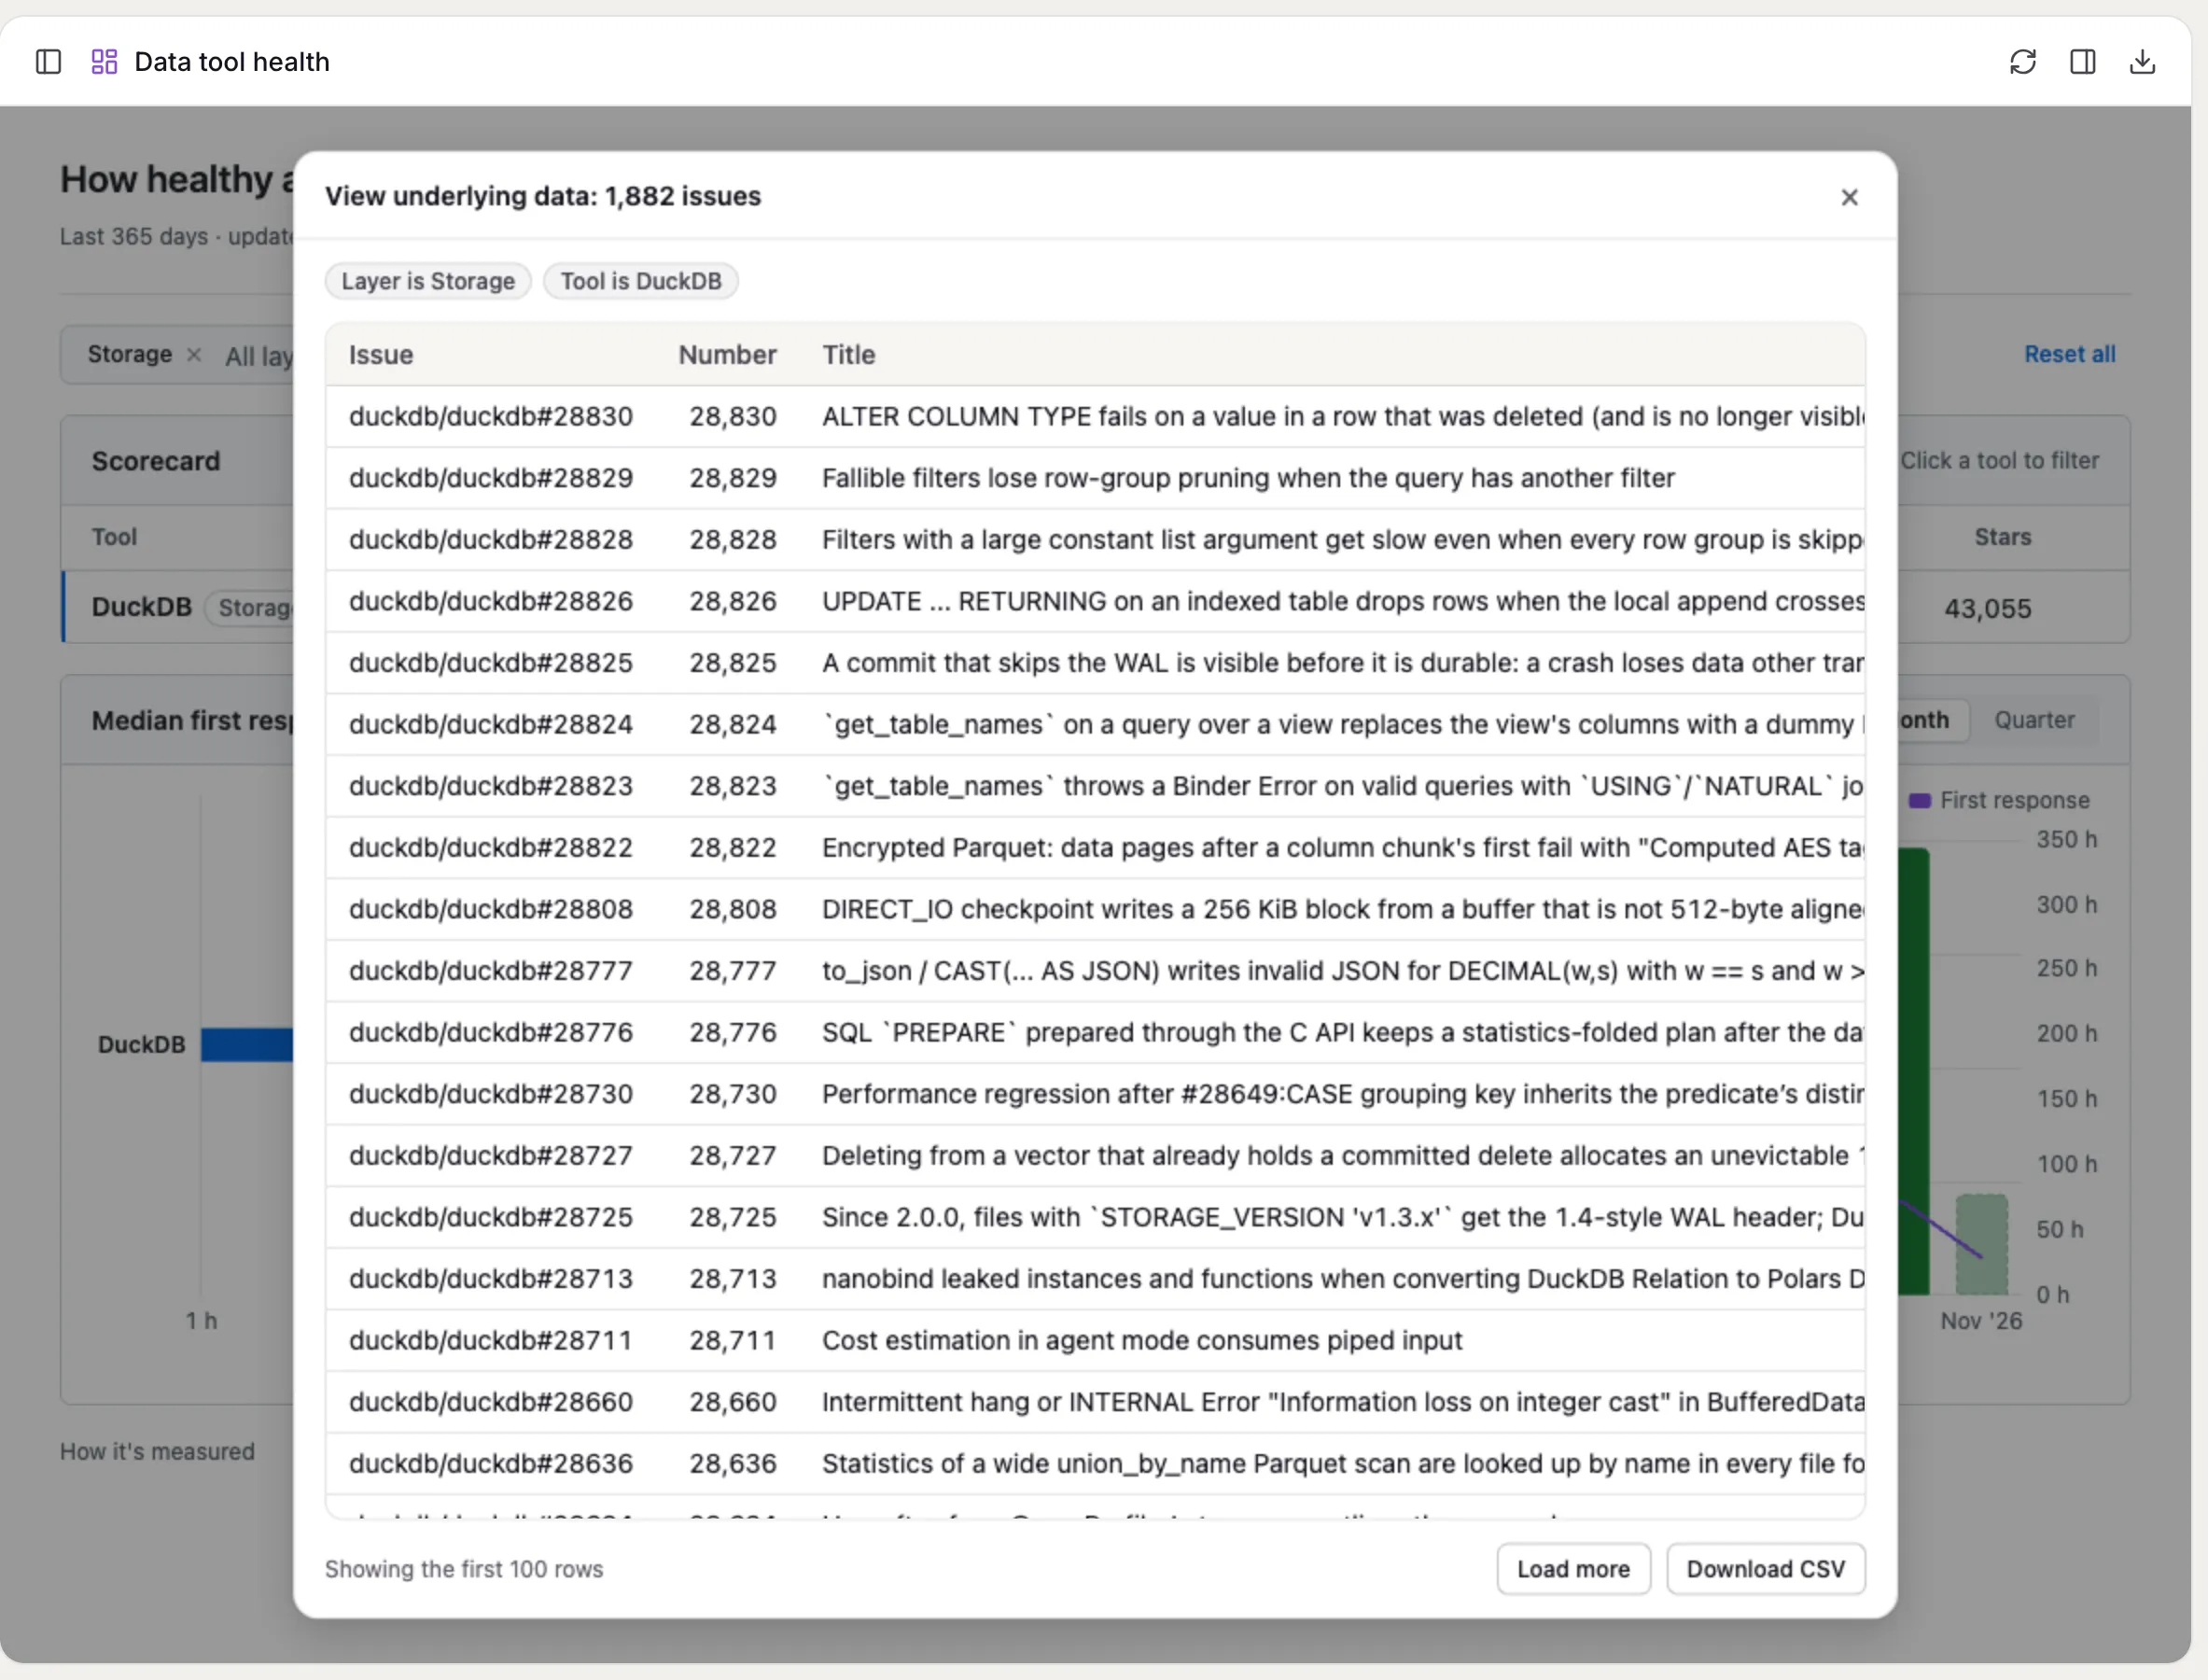
Một số tính năng anfra có sẵn, mình và agent không phải viết code:
- cửa sổ View underlying data, có phân trang và tải CSV
- export cả trang ra PNG và PDF
- logic xử lý filter, cross-filtering và date drill
App chỉ cần khai báo mỗi control gắn với field nào. anfra tự viết lại query.
5.6 Insight
Dữ liệu tính đến 14/11/2026, gồm các issue và pull request được mở trong 365 ngày trước đó.
Metabase phản hồi nhanh nhất, nhưng không phản hồi nhiều nhất. Thời gian median từ lúc community mở issue đến khi maintainer trả lời lần đầu:
- Metabase: 15.6 giờ
- DuckDB: 35 giờ
- SQLMesh: khoảng 64 ngày
- Evidence: khoảng 132 ngày
Tuy nhiên, nhanh không có nghĩa là đầy đủ. Metabase chỉ trả lời 36% community issue trong 10 comment đầu tiên, trong khi Superset trả lời 60%.
SQLMesh dựa vào community nhiều nhất. Tỷ lệ pull request đã merge do người ngoài core team mở:
- SQLMesh: 57%
- DuckDB: 32%
- Superset: 30%
- Metabase và Cube: dưới 3%
Một con số từng bị sai. Phiên bản đầu cho rằng community mở 85% số pull request đã merge của Metabase. Con số này sai vì:
- Metabase ẩn danh sách thành viên org, nên GitHub gắn nhãn chính các engineer của họ là contributor.
- “Contributor” đứng đầu của họ là
github-automation-metabase, một tài khoản user chứ không phải GitHub App, với 5,599 pull request đã merge.
Để sửa, mình thêm hai rule vào một dbt macro:
- ai từng merge một pull request thì được tính là core team
- các tài khoản automation được tính là bot
Sau khi sửa, tỷ lệ community của Metabase giảm từ 85% xuống 0.2%, của dbt giảm từ 83% xuống 8%. Mọi metric dùng author type đều được cập nhật cùng lúc, vì chúng dùng chung một macro.
Agent, không phải mình, là người phát hiện lỗi. Khi đối chiếu metric với SQL thuần, agent thấy hai con số mâu thuẫn: Metabase chỉ trả lời 3% community issue, nhưng community lại mở tới 85% số pull request đã merge.
Còn anfra? Đây là project mới nhất trong danh sách, chỉ có 3 issue trong năm qua. Một issue đến từ community và chưa được trả lời, nên anfra chưa có số liệu response time. Bù lại, anfra ra release đều đặn: 36 release trong năm.
5.7 Chia sẻ trên anfra Cloud
anfra serve chỉ chạy trên máy của bạn. Để chia sẻ dashboard, hãy publish project lên anfra Cloud, hiện miễn phí trong giai đoạn beta.
Lưu ý: anfra Cloud không đọc được file DuckDB trên máy của bạn, nên bạn cần chuyển data source sang MotherDuck. dlt và dbt sẽ ghi vào MotherDuck khi đặt TARGET=motherduck. Free tier dư sức: cả database chỉ khoảng 28 MB, còn MotherDuck Lite cho 10 GB.
Org cần một data source cùng tên github để giữ nguyên AML. Ở local, data source này là DuckDB; trên cloud là MotherDuck:
# the org's data source: add it once, and never commit the token
data_sources:
  github:
    type: motherduck
    connection:
      token: <your MotherDuck token>
      dbname: github
anfra publish check
anfra publish --set-org https://us.anfra.ai/o/lelouvincx --create-data-sourcesDashboard của mình ở đây: zero-dollar-data-stack.pages.holistics.dev.
6. Dọn dẹp
Dừng anfra serve là máy bạn không còn chạy gì. Để tắt refresh hằng ngày, hãy disable workflow trong tab Actions của GitHub.
7. Những điều cần cân nhắc
Stack này có giới hạn:
- AI agent không miễn phí. Mọi thứ khác đều miễn phí. Mình dùng gói Claude $20/tháng.
- Gói miễn phí có giới hạn. MotherDuck Lite cho 10 GB storage và 10 giờ compute mỗi tháng. GitHub Actions chỉ miễn phí không giới hạn với public repo. anfra Cloud miễn phí trong giai đoạn beta, giá sau beta chưa công bố. Các điều khoản này có thể thay đổi, nên hãy kiểm tra kỹ trước khi dùng cho công ty.
- DuckDB chỉ cho phép một writer. Một job chạy mỗi ngày thì không sao. Nếu nhiều pipeline cần ghi cùng lúc, hãy dùng MotherDuck hoặc một warehouse khác.
- anfra còn mới nhưng nhiều tiềm năng. Trong quá trình sử dụng, mình gặp hai điểm bất tiện:
anfra servegiữ file DuckDB mở, nên cần dừng nó trước khi chạymake ingesthoặc dbt ở local.- Mỗi lần publish sẽ ghi đè toàn bộ org, và data source trên cloud phải trùng tên với data source ở local.
Kết luận
Trong bài này, chúng ta đã xây:
- ingestion từ GitHub API với dlt
- một warehouse DuckDB, được model hoá bằng dbt
- lịch chạy hằng ngày miễn phí với GitHub Actions
- một semantic layer với anfra, nơi mỗi metric chỉ được định nghĩa một lần
- một dashboard do AI agent xây, chia sẻ bằng một đường link
Mỗi layer của modern data stack giờ đều có lựa chọn miễn phí và open-source. BI từng là layer còn thiếu. Với semantic layer viết bằng code và một AI agent, khoảng trống đó đã được lấp.
Muốn thêm tool vào dashboard? Bạn có thể gửi PR. Nếu bạn làm thử hoặc gặp lỗi, hãy mở issue trên repo hoặc liên hệ mình qua LinkedIn hay X.
FAQ
Có modern data stack miễn phí nào bao gồm cả BI không? Có. dlt, DuckDB, dbt Core và GitHub Actions lo phần ingestion đến orchestration, còn anfra bổ sung semantic layer và BI open-source. Bài này xây trọn một stack như vậy.
Có dùng anfra với dbt được không? Được. anfra đọc manifest của dbt project làm context, và model của anfra nằm ngay trên dbt mart.
anfra có kết nối được với DuckDB không? Có, khi dùng ở local hoặc self-host. anfra Cloud không hỗ trợ file DuckDB, nên hãy dùng MotherDuck nếu muốn chia sẻ app trên đó.
Có cần học AQL không? Lúc đầu thì không, vì AI agent sẽ viết AQL. Nhưng bạn nên đọc hiểu AQL để review, giống như review SQL do agent viết.
Stack này đã sẵn sàng cho production chưa? Với side project hay team nhỏ thì rồi. Với team lớn hơn thì chưa, nếu giữ nguyên: DuckDB và giới hạn miễn phí của GitHub Actions sẽ là nút thắt đầu tiên. Điểm cộng là cả stack đều là code, nên bạn có thể thay storage và orchestration bằng công cụ mạnh hơn mà vẫn giữ phần còn lại, nhất là metric và business context bạn đã định nghĩa trong AMQL (AML và AQL của anfra).
Đọc thêm
- Goodreads ELT pipelines, stack cũ của mình
- dbt tutorial của Start Data Engineering
- I let a coding agent build my dashboard. I didn’t let it touch the math của Mark Pham
- anfra docs